Cursor Meetup Nagoyaに参加してきたぞ!
このブログもすっかりイベントレポ記事ばかりになっております。 というわけで先日、名古屋の中日ビルで開催された「Cursor Meetup Nagoya」に参加してきました。
名古屋でのイベントは珍しいので、開催を知った時には「これは行かないと!」と即応募しました。
これは世界各地で開催されているCursor Meetupの日本版で、LTやCursorチームからの動画メッセージ紹介、そして交流会という構成になっておりました。 毎度同様印象に残ったところをレポートしていきます〜
セッション1:本から始める初心者目線のCursor入門(わか氏)
トップバッターは、開発未経験・社会人3年目という完全な初心者視点からの発表。先週の土曜日からCursorを触り始めたばかりというフレッシュさで、技術書『Cursor完全ガイド』を使って体系的に学ぶメリットを3つ挙げていました。
- まず、個人開発のアイデアが思いつかなくても、本に「このプロンプトを実行してみよう」という手順が詳細に書かれているため迷わずスタートできる点。
- 次に、本のサポートとしてGitHubからサンプルコードをダウンロードできるので、「変更するためのファイルを用意する」という面倒な初期準備をスキップして、すぐにAIによる修正体験という楽しい部分を味わえる点。
- そして、技術書は出版後にUIが古くなりがちだけど、GitHubリポジトリ上で最新の画面や手順の差分がアップデート・サポートされていたおかげで、つまずくことなく学習できたとのこと。
初心者ならではの視点で、「本から入る」学習法のメリットを整理してくれていて説得力がありました。
セッション2:Cursorでリモート開発:安全と引き換えに増えるめんどくささ(tatsuno氏)
続いては、AMDのGPUクラウドを提供する企業に所属する立場と、ヘビーユーザーとしての視点からの発表。Cursorをプログラミングだけでなく、Word・Excel作成や経理確認まで業務全般で活用しているそうで、特に「Composer 2.5(fast)」の動作の軽快さを高く評価していました。(私もここのところはComposer 2.5のFastの使用頻度が爆上がりしております)
一方で、ローカルのMacでAIをフル稼働させると裏で様々なプロセスが立ち上がる懸念があること、GPUを積んだ別マシンで開発したいというニーズから、リモート開発の重要性を語っていました。ただ、リモート先でCursorを開くにはSSHのコンフィグ設定(ホストやポート指定)を毎回行う必要があり、これが結構めんどくさい、と。
この解決策として、クラウド上からワンクリックでCursorが立ち上がる専用アプリを自作し、デモを披露。面倒なSSH設定をスキップして即座にリモート開発環境を構築できる、という実用的な内容でした。
セッション3:Cursorを活用したPCレス生活(mori issei氏)
AI企業を経営するmori issei氏は、Slackやメールで降ってくるタスクをAIエージェントに処理させる際、「わざわざPCを開いて指示を出すこと自体が面倒」という悩みを持っていたそう。過去には画面のないMac miniを常時稼働させるアプローチも試したものの、ネットワークやVPNの維持に限界があったとのこと。
そこで構築したのが、Cursorの「Cloud Agent(クラウドエージェント)」「Automations(オートメーション)」「iOSアプリ」の3つを組み合わせたPCレスワークフロー。Slack・Gmail・カレンダーをMCP連携させ、タスクをNotionに自動リスト化して15分おきに自動検知。移動中にスマホへ届くプッシュ通知を起点に、iOSアプリからクラウド上のエージェントへ指示を出し、エージェントはクラウド上で背景動作(スクショ撮影なども含む)を行う。PCを開かずとも作業が完結するという、なかなか未来的なワークフローでした。
セッション4:Cursorで自分のAPIや任意のLLMを使う方法(Kuu氏)
メルカリのKuuさんからは、企業でCursorを導入(チームプランなど)する際の、「オンデマンドの従量課金が予算申請のハードルになる」というリアルな悩みの共有でした。
これを回避しつつCursorの優れたUI(ハーネス)を活用する泥臭いハックとして、2つの手法を解説していました。
1つはOpenAIのAPIキーを直接セットして、Cursor側ではなく手持ちのOpenAIコンソール側で課金させる方法(ただしリクエストごとに1回約160円などコストは発生)。
もう1つは、Cursorの「Base URL」を上書きして、OpenAI互換の外部API(さくらのAIエンジンなど、無料で使えるオープンソースモデルのAPI)のURLとキーをセットし、モデル選択画面の「Enter model name」に使いたいモデル名を直接入力して追加する方法。
これでCursorの追加課金を完全に回避しながら任意のLLMを動かせるという、実践的な裏技でした。 (チームプランはどうしてもコスパ悪いので、個人的にはPro+とかを立て替えて経費精算できたら良さそうだなーと思っています)
メインセッション&Q&A:Tibor Sekelj氏
メインセッションは、Cursorの創業者ではなく25年以上のエンジニア経験を持ち、アフリカやスリランカのイベントでも登壇している「Cursor Community Developer」ことTibor Sekelj氏。フォーラムでの詳しすぎる回答がきっかけで運営に招待されたという経緯の持ち主です。
Q&Aでは実践的な知見がいくつも語られていました。最近公開された「Fable」モデルは高価だけど、「素晴らしい計画(プラン)を立てること」と「サブエージェントへのタスク分配(オーケストレーション)」に非常に優れているとのこと。実際の作業はComposer 2.5などの安価なモデルをサブエージェントとして動かすことで、効率的かつ高度な開発が可能になるという整理は、コスト意識のある開発者には刺さる話だったと思います。
初心者へのアドバイスとしては、最初は「Planモード」をオンにして達成したい目標を記述し、AIに計画を立てさせてから開発を進めるのが最も簡単でおすすめとのこと。
お気に入りの機能としては、エラー文やスタックトレースを貼り付けるだけでAIがコンテキストを読み取りピンポイントでバグ修正してくれる「デバッグ機能」を絶賛していました。 ↑ちなみにこちらはは私が質問した内容でした。デバッグ機能はCursor独自の機能で私も愛用しています。(トータルで十数時間削減できてる)
その他
じゃんけん大会
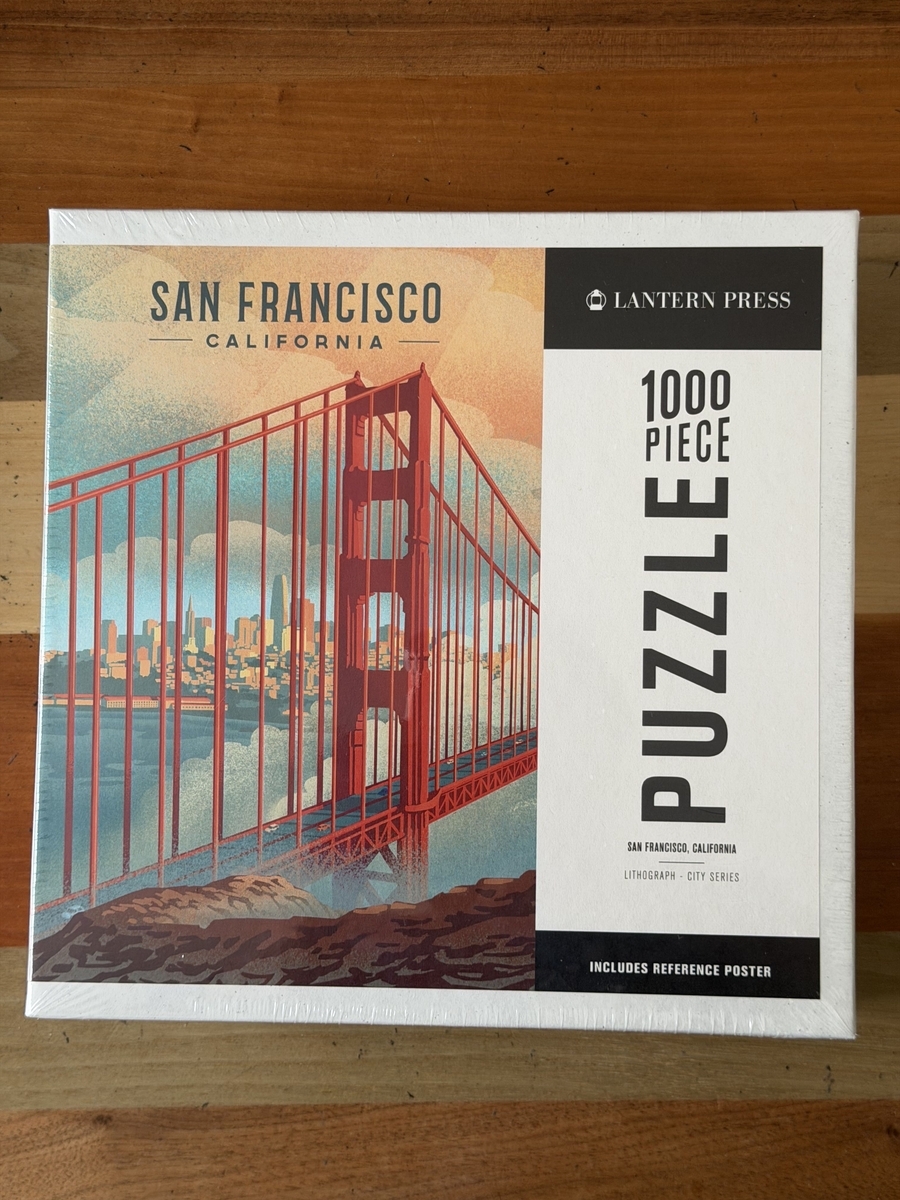
今回はAIAU主催イベントということもあり、運営メンバーが主に進行などを行なってくださっていまして、その中でAI開発の発信や書籍の執筆で知られる、きのぴーさん( https://x.com/kinopee_ai)が先日のCursorのComplieというイベントに参加されたそうで、その際に買ったアメリカのお土産をじゃんけん大会で勝者にプレゼントする企画がありました。 cursor.com
いくつか商品はあったのですが、その中の1つのジグソーパズルを運よく勝ち抜いてゲットしました!
懇親会
オフラインイベント恒例の懇親会を今回も参加してきました。懇親会ではピザやスナックが用意されていることが通例なんですが、今回はお寿司が珍しく用意されておりました。夕食を食べた後でしたが、気にせずパクパク食べてしまいました。
交流の方も元同僚がたまたま参加してたり、別のイベントで仲良くなった方とも再開したり、新たに交流が広がったりで大満足でした!
まとめ
久々のオフラインイベントへの参加でしたが、やっぱり楽しいですね。TL登壇者の話も勉強になったし、Tibor Sekeljさんに質問もできたし、懇親会も楽しかったし、ついでにジグソーパズルもゲットできたしでいうことなしのイベントでした!
CodeRabbit User Group Nagoya #1に参加してきたぞ!
先日、クラスメソッド株式会社の名古屋オフィスにて開催された「CodeRabbit User Group Nagoya #1」に参加してきました。
CodeRabbitのユーザーが実際の運用ナレッジを持ち寄るコミュニティイベントで、名古屋開催ということもありちょうど足を運べる機会。 CodeRabbit User Groupイベントに参加するのは2回目で、こちらの記事で1回目の内容を書いております。 なかなか濃い内容だったので、今回は全てのセッションをいつも通りレポートしていきます。
セッション1:CodeRabbitの最新アップデート(アツシさん / CodeRabbitデベロッパーアドボケイト)
最初はCodeRabbitのデベロッパーアドボケイトを担当するアツシさんによるアップデート紹介。公式から直接話が聞けるのは、ユーザーグループ系イベントの醍醐味。
2026年2月以降の主なアップデートをまとめると↓
- Pro Plusプランの追加、FortranやSmartyなどのLinterも追加
- Claude Code等向けのAIエージェントプラグインのリリース(エージェントが書いたコードを自動でレビューできるようになった)
- CodeRabbit Plan:IssueでCodeRabbitと実装プランを相談できる機能。AIに不慣れなメンバーが均質なプロンプトを作る練習にもなるという副次効果がある
- ちなみにプラン構成がちょっと前に変わりまして、以前まではProプランでも使えていました
- Multi-repo Analysis:フロントエンド変更時にバックエンドのAPIなど別リポジトリを参照してレビューできるようになった
- Proプランは1リポジトリ、Proプラスは10レポジトリまで参照できます
- AIスロップ検出:AI生成っぽい低品質コードを検出して「slop」ラベルを自動付与。ジュニアエンジニアがAI生成コードを無確認で投げることを抑制できる
チャットからの操作も強化されていて、指摘を一括修正する「Auto-fix」、力技のコードを整理する「Simplify」、マージコンフリクトを自動解消するコミット生成など、かゆいところに手が届く機能がどんどん増えている感じですね。
ベンチマークの話も出ていて、F1スコア(正確性とノイズのバランス)で1位を獲得しているとのこと。「提案は多いが、見つけるべきバグは確実に見逃さない」というスタンスらしいですねー。
※ 参照↓(最近はCubic Dev AIというレビューサービスが上位にいたりするので気になるところ👀)
セッション2:CodeRabbitのレビューと自動AI修正を組み合わせた開発手法の紹介(クマルさん / ABC株式会社)
2本目は英国リーズ大学にてCSの修士号を取得したクマルさんによる、PRレビューからマージまでを全自動化する「AIオートマージ」の話。
これまでのAIオートマージはサーバーを常時稼働させる必要があり、サーバーが落ちると自動化も止まるという課題があった。それを解決するのがClaude Code「ルーティン」という仕組みで、GitHubのイベント(コードレビュー等)をトリガーにサーバーレスでClaudeを動かすことができる。現在はプレビュー版として有料プラン向けに提供されている。
処理の流れはシンプルで、
- CodeRabbitがレビューコメントを投稿した瞬間にルーティンが起動
- Claudeが自動修正
- CodeRabbitがApproveしたらGitHubのオートマージが走る
という感じで、ルーティン自体はマージに関与せず、マージはGitHubの保護ルールに委ねる設計になっているとのこと。
気をつけないといけないのが無限ループ問題。「CodeRabbitのレビュー→Claudeの修正→再度CodeRabbitのレビュー→...」が延々と繰り返されないよう、プロンプトで「2回目以降は新しい指摘だけ対応する」と明示しておく必要がある。
あと、導入時はいきなりオートマージを有効にするのではなく、まずClaudeの挙動を目で見て確認してから段階的に有効化するのが強く推奨されておりました。 いきなりオートマージを有効にするのは怖いですからねー。
セッション3:.coderabbit.yaml を育てる仕組み(小越広臣さん / フリー株式会社)
2本目はフリー株式会社のアナリティクスエンジニア・小越広臣さんによる、coderabbit.yamlの運用と検証の話でした。
セキュリティの観点から全コードをLLMに読ませられない状況で、プロジェクト固有のルールを適用させるには「Learningsよりcoderabbit.yamlへの明示的な定義のほうが確実」という結論にたどり着いたそう。
ただ、Claude Code等のAIエージェント用のルールファイル(Markdown)とcoderabbit.yamlを二重管理するのは当然
めんどくさい。
わかる。
そこで、Markdownをルールの単一情報源にして、タグでPythonスクリプトに解析させ、フックでcoderabbit.yamlを自動生成する仕組みを作ったとのこと。これは普通にうまいアプローチだと思いました。
検証の結果として興味深かったのが「AIはインデントや大文字小文字の統一をほとんど指摘しない」という発見。AIは設計やロジックの指摘は得意だけど、スタイルガイド的な部分の検出はLintに任せるべき、という結論に至っていました。
AIとLintは競合ではなく相互補完、という整理はすっきりしていて納得感がありましたね。あと、検証をしたからこそこういう発見もあるよなーと、改めて自ら検証していくスタンスは大切だなと学びました。
セッション4: スタメンのコードレビュー2025-2026(takuyaさん / スタメンCTO)
最後はスタメンのCTO・takuyaさんによる、社内でのAIレビューツール活用と育成の話。
Gemini Code Assist、CodeRabbit(OSSバージョン)など複数ツールを導入しているものの、AIがコンテキスト外のコードを読めなかったり、AI生成の低品質なコード(AIスロップ)がそのままPRに投げ込まれたりという課題に直面しているとのこと。
それに対する育成のアプローチとして、2ヶ月間の教育プログラムを実施しているそうで、細かいルールを増やすのではなく「シャドウイングによる観察」を重視して、機能単位でチームに委譲していく方針だという。
コスト面では、Kilo Codeという別ツールの検証もしていて、複雑なPRには高性能モデル、シンプルなPRには軽量モデル、みたいにモデルを使い分けるアプローチにも期待しているらしい。
AIレビューのコストという観点をどう扱うかは規模が大きくなるほど重要になってくるし、このあたりのリアルな話は参考になりました。
まとめ
AIコードレビューの活用はもはや「導入するかどうか」の段階ではなくなってきていて、「いかに運用するか?」へと移ってきている印象でした。 AIコーディング同様にレビューも当たり前になってきたので、自分自身も周りがどういう運用をしているかが気になったので、今回も多変参加できて満足でした!
ちなみに余談ですが、Claude Code等のAIエージェント用のルールファイル(Markdown)とcoderabbit.yamlを二重管理問題は、coderabit.yamlファイルの設定で
knowledge_base:
  code_guidelines:
    filePatterns:
      - "**/CLAUDE.md"
      - "**/docs/style-guide.md"
こんな風に書くことで参照してくれるので、解決できそうです💡
Codex Meetup Tokyo #1 に参加してきたぞ!
https://aiau.connpass.com/event/384679/
ここんとこ週1ペースで参加しております、テック系のオフラインイベント。今回もいつものように参加レポを書いていきます。 先日、メルカリさんのオフィス(六本木ヒルズ)で開催された Codex Meetup Tokyo #1 に参加してきました。
主催はAIエージェントユーザー会(AIAU)。Codexの知見を共有し合うイベントで、オフラインだけで300人以上が集まるという、かなり熱量の高い会でした。
Codexの最新アップデートを全部キャッチアップする(Kuu)
最初のセッションはCodexアンバサダーも務めるKuuさんによる、怒涛のアップデート解説。
2026年1月以降、Codexの開発スピードが劇的に加速していて、数週間単位でバンバン機能が追加されている(最近のClaude Codeでも同じようなことを聞いたような)。 正直一般人が全部追うのは不可能なレベルのスピード感とのことで、笑えない話だなと思いながら聞いていました。
注目モデルとして挙げられていたのがこの3つ。
- GPT-5.4:現状最も安定した選択肢。
/fast指定でスピードアップもできる - GPT-5.4 mini / nano:3月17日リリースの新モデル。性能・速度・価格のバランスが良い
- Codex Spark:一番注目度が高かった。Cerebrasという特殊ハードウェアで動くモデルで、メモリを計算資源の真横に大量配置するアーキテクチャが特徴。「新幹線と飛行機くらい違う」という表現が印象的だった。現状はコンテキストウィンドウが128Kと狭いが、ここが改善されたら化けそう。
ツールの使い分けとしては Codex CLIが基本のおすすめ、GUIが欲しければCodex App、非同期でバックグラウンド処理したいならCodex Cloudという整理でした。 個人的にはCursor内で拡張機能を普段使いし、個人開発の簡単なタスクはAppで行っております。
あと地味に嬉しい情報として、4月2日までレートリミットがお得な期間らしい。試し時。
キャッチアップの方法として「GitHubのリリースページを右クリックで日本語翻訳する」というシンプルな裏技も紹介されていて、そういうのでいいんだよなと思いました。 とはいえ先述の通り「爆速でアプデしてる」ので無理に追うのはしんどくなるので個人的に推奨はしておりません。
Multi-Agentsを理解しよう(akihiro_genai)
続いてAndroidエンジニアのakihiroさんによる、Codexのサブエージェント機能の解説。
そもそもサブエージェントがなぜ必要かというと、LLMはスレッドが長くなるほど出力の質が落ちるという性質がある。そこで別エージェントに作業を任せ、「結果だけ」をメインに返すことでコンテキストを効率的に管理するのが目的とのこと。
公式が推奨する使い方として面白かったのが「Read-heavyタスクに特化させる」という発想。調査・要約・ファクトチェックなど「情報を集めてくる系」のタスクに大量のサブエージェントを割り当てるのがベストプラクティスで、書き込みを複数エージェントで並行するとコンフリクトのリスクがあるから推奨されないとのこと。
PRレビューをセキュリティ・品質・バグ検出といった観点ごとに独立したエージェントに担当させるというユースケースも紹介されていた。注意力を1テーマに集中させることで精度が上がるのは納得感がありました。 この辺はAgent Skillsとかにして再現性を高めていくのが良さそうだなーと思いました。この辺りもどんどん簡略させてlintチェックぐらいの感覚になるようにしていきたいですね。
検証結果として「サブエージェントはAIが自己判断で勝手に起動することはない」という事実も共有されていた。Descriptionに「必ずサブエージェントを起動せよ」と書いても、ユーザーからの明示的な指示がないと動かないらしい。エージェントが無限増殖して収拾がつかなくなるのを防ぐためだろう、という考察には「確かに…」となりました。 この辺は自動的に起動するClaude Codeとの違いがでて面白いですねー。
コーディングエージェントのポータビリティについて(ぬこぬこ)
Claude CodeとCodex CLIを両方使っているエンジニアなら刺さるテーマ。「ツールごとに設定ファイルを個別に育ててしまって、プロンプト資産が分断されてる問題」を解決するアプローチの話でした。
管理対象を絞るのが重要で、推奨されていたのはこの3つだけ。
- 指示書(
agents.md/claude.md) - Skills
- MCP
逆に、ツール間の仕様差が大きいPermissionsや、Skillsに移行しつつあるSlash Commandsは管理対象から外すとのこと。
具体的な手法として紹介されていたのがシンボリックリンクによる一元管理。専用リポジトリに大元のファイルを置き、各プロジェクトの設定ファイルにシンボリックリンクを貼ることで、1ファイルを更新するだけで全ツールに反映される仕組みを作っている。これはシンプルだけど確かに効きますよね。
Skillsの管理にはVercelが提供するnpx skillsというCLIツールを使い、自作スキルをGitHubのプライベートリポジトリにまとめておいて手軽にインストールできる形にしているとのこと。
このアプローチの副産物として、「新しいAIモデルが出たときに同じ指示書を使ってツール間の挙動の差を正確に比較できる」というメリットも挙げられていて「なるほどなー」と思いました。
あとセッション最後のおまけとして、思い通りに動かないエージェントへのイライラ対策として「AIに妹ロールを付与してお兄ちゃんと呼ばせる」という解決策が紹介されていて、会場がちょっと笑いに包まれていました。 (結構会場には賛同者がいたのが意外でした笑)
Codex100%のスマホアプリをリリースした話(GeminiDK)
個人的に一番インパクトがあったセッション。神村さんによる、10年前にObjective-Cで作って5年ほど放置していたアプリをCodexで蘇らせた話。
放置中も累計120万ダウンロードを達成していたことが判明し、レビュー欄は「すぐ落ちる」で荒れていたものの需要があると確信して今年1月に作り直しを決意したとのこと。
驚いたのが開発期間で、iOS(Swift)への移植が1週間、Android(Kotlin)への移植が5日。ストアへの申請・リリースまで含めて3週間で完了している。
開発の進め方はシンプルで、メモリ管理などのコアアーキテクチャは人間がしっかり設計し、機能の実装はCodexに丸投げ。iOS版からAndroid版へ移植する際も「iOSのコードを見に行って同じ機能を実装して」と指示するだけでほぼ完璧なコードが出てきたらしく、人間の作業は「依頼→テスト→マージ」を繰り返すだけだったとのこと。
リリース後1ヶ月半・約1万人が利用した時点でのクラッシュフリーユーザー率が99.8%というのは普通にすごい。「自分で開発する必要がない」と感じるほどだったと語っていたのが印象的だった。
スマホアプリには疎いですが、AIコーディングの恩恵はここまであるのかーと感心した。他にも古くてメンテしてなかったアプリをAIで蘇らせる例は結構ありそうですね。
まとめ
Codexを取り巻くスピード感と、実際にプロダクションで使い倒している人たちの知見を一気に浴びられた、密度の高いイベントでした。 あとはCodexの5.3が出たあたりから注目度も急上昇した感があるので、今回の参加者の多さにも頷けましたねー。
個人的には「設定ファイルのポータビリティ」と「ネイティブコードへのポーティングが単純作業化する」という2つの話が特に刺さった。Claude Codeをメインで使っている身としては、設定ファイルの共通管理は今すぐ取り入れたいところ。 あとはあまり触れられていなかった、「仕様策定 → テスト」までのワークフローを聞ければ最高だなーと思いました。
今回も終わりの懇親会にもちょっとだけ参加しましたが、やはりオフラインに参加するだけあって積極的に話せる人が多かった印象でした。
